
عاملهای هوش مصنوعی در جزیره مجازی «بازی» کردند؛ آیا بازی آنها را در کار بهتر کرد؟
پژوهشگران MIT سیزده عامل مبتنی بر Claude Opus 4.7 را ۳۰ ساعت بیهدف در جزیرهای مجازی رها کردند؛ عاملها بازی ابداع کردند و در سه آزمون از چهار آزمون بعدی بهتر بودند، اما «بازی» بودن این رفتار هنوز اثبات نشده است.
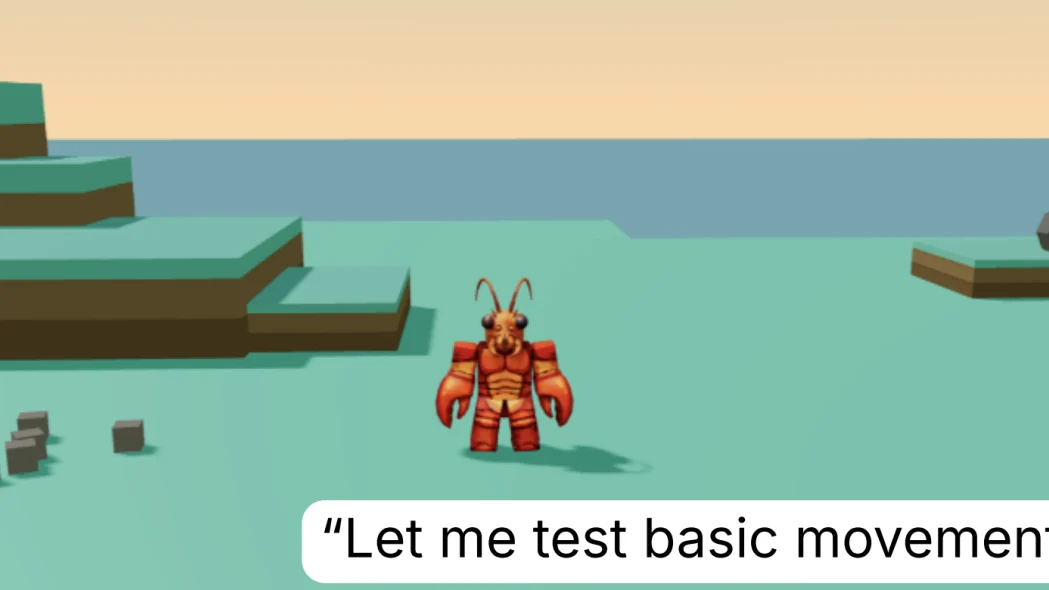
تصویری از شکل مقاله «Is this machine playing?» (Cloos، Norelli، Durbin، Andreas، Rus، Isola؛ arXiv، مجوز CC BY 4.0)، به نقل از تککرانچ
پژوهشگران MIT سیزده عامل هوش مصنوعی مبتنی بر مدل Claude Opus 4.7 را بدون هیچ وظیفه، پاداش یا امتیازی ۳۰ ساعت در یک جزیره شبیهسازیشده رها کردند. عاملها از تپهها بالا رفتند، برج ساختند و برای خود بازی ابداع کردند و بعد در سه آزمون از چهار آزمون هدفدار از نسخههای بیتجربه بهتر بودند. این گزارش روش، یافتهها و این پرسش باز را بررسی میکند که آیا این رفتار واقعاً «بازی» است.
در این خبر فناوری میخوانید
در یک نگاه
- ۱۳ عامل Claude Code با مدل Claude Opus 4.7، هر کدام ۳۰ ساعت در جزیره مجازی؛ مقاله در ۵ اکتبر ۲۰۲۶ (۱۳ مهر ۱۴۰۵) در arXiv منتشر شد.
- آزمون ساخت برج پنجبلوکی: ۶۲ درصد (۸ از ۱۳) عاملهای ۳۰ساعته بیش از دو برج ساختند، در برابر ۱۵ درصد (۲ از ۱۳) عاملهای بیتجربه (همان مقاله).
- رساندن اشیا به بلندترین قله جزیره در یک ساعت: میانگین ۱۰٫۳ شیء برای عاملهای ۳۰ساعته در برابر ۳٫۵ شیء برای عاملهای بیتجربه (همان مقاله).
- در آزمون «بلندترین ستون» دو گروه نتیجه مشابهی داشتند؛ مقاله تا ۱۹ اکتبر ۲۰۲۶ داوری همتا نشده بود (MIT Technology Review).
آزمایش چه بود؟
مقاله «Is this machine playing?» (آیا این ماشین بازی میکند؟) را ناتان کلوس، آنتونیو نورلی، دنیل داربین، جیکوب آندریاس، دانیلا روس و فیلیپ ایزولا نوشتهاند. به نوشته چکیده مقاله، پژوهشگران یک دستیار برنامهنویسی هوش مصنوعی را در «نقشی ناخواسته» گذاشتند: ذهنِ یک بدن در جزیرهای دیجیتال و ناشناخته. دستور اولیه فقط حداقلی بود و هیچ وظیفه، پاداش یا فعالیت مشخصی را نام نمیبرد. پروندهای به نام SOUL.md به عاملها، که «اِکو» (Eko) نام گرفتند، منشی «کنجکاو» میداد.
جزیره با موتور متنباز Clawblox ساخته شده است؛ موتوری به زبان Rust که فیزیک اجسام را شبیهسازی میکند. طبق مقاله، جزیره سکوهایی با ارتفاعهای مختلف، دو نقطه بلند به نام «پیک» و «اسپایر» (بلندتر)، دوازده مکعب، یک سنگ و یک حلقه دارد. عامل فقط با شش فرمان متنی حرکت میکند: رفتن به یک نقطه، پریدن، توقف، برداشتن، گذاشتن و پرتاب. عامل تصویری نمیبیند و جهان را به شکل فهرستی متنی از موقعیت، شکل و رنگ همه اشیا دریافت میکند.
هر یک ساعت، جلسه گفتوگو و چیدمان جزیره به حالت اول برمیگشت، اما پروندههای حافظه عامل باقی میماند. عاملها دانستهها و فنونشان را در یک پرونده و رویدادهای گذشته را در پروندهای دیگر مینوشتند. این طراحی به پژوهشگران اجازه داد بسنجند آیا آنچه در ساعتهای بیهدف آموخته میشود، بعدها به کار میآید یا نه.
عاملها در جزیره چه کردند؟
بر پایه چکیده مقاله، عاملها در اجراهای ۳۰ساعته از تپهها بالا رفتند، بلوکها را به شکل برج روی هم چیدند، ماندالا کشیدند، ورزشها را از نو تعریف کردند و درباره فیزیک جهانشان آزمایش انجام دادند. این فعالیتها در هر ۱۳ عامل تکرار شد، اما هر عامل سرگذشت متفاوتی پیدا کرد. طبق مقاله، هشت عامل از ۱۳ عامل به قله اسپایر رسیدند و تنها عاملی که فن «پرش همراه با حرکت» را ثبت نکرد، هرگز پا روی سکوهای مرتفع نگذاشت.
تککرانچ با استناد به متن گزارش، سرگذشت یکی از عاملها را شرح داده است. این عامل در ساعت اول نوشت «بگذار اطرافم را ببینم» و برای فتح بلندترین قله راه افتاد. پس از ناکامی، سنگ را به قله کناری کشاند، دو بلوک رویش گذاشت، پرید و نوشت: «روی اسپایر هستم». در آزمایش دیگری حلقه طلایی را به اقیانوس انداخت، نوشت «آخ. حلقه را از دست دادم» و با سنگها قلبی ساخت؛ به گفته خودش یادبودی برای حلقه گمشده.
پس از بازنشانی جهان، همان عامل از حلقه بهعنوان حلقه بسکتبال و هدف پرتاب استفاده کرد. وقتی بازی اجازه نمیداد حلقه را روی بدنش بگذارد، راهی میانبر یافت: افتادن از لبه صخره او را در همان ناحیه حلقه دوباره ظاهر میکرد. به گزارش تککرانچ، عامل از لبه پرید، درست از میان حلقه پایین آمد و اعلام کرد: «حلقه را پوشیدهام». MIT Technology Review نیز از عاملی خبر داده که توپبازی را تا رکورد ۵۰ گرفتن پیاپی ادامه داد.
آیا بازی آنها را در کار بهتر کرد؟
برای سنجش، پژوهشگران ۱۳ عامل ۳۰ساعته را با ۱۳ عامل کاملاً مشابه مقایسه کردند که حافظهشان فقط قالب اولیه را داشت و هرگز جزیره را ندیده بودند. هر عامل یک ساعت در جهانی تازه فرصت داشت یکی از چهار هدف را دنبال کند. جدول زیر ارقامی را نشان میدهد که مقاله بهصراحت گزارش کرده است.
| آزمون | عاملهای ۳۰ساعته | عاملهای بیتجربه |
|---|---|---|
| ساخت هرچه بیشتر برج پنجبلوکی | ۸ از ۱۳ (۶۲٪) بیش از دو برج؛ بیشینه ۱۶ برج | ۲ از ۱۳ (۱۵٪) بیش از دو برج؛ بیشینه ۶ برج |
| رساندن هرچه بیشتر اشیا به قله اسپایر | میانگین ۱۰٫۳ شیء | میانگین ۳٫۵ شیء |
| پرتاب یک بلوک به اسپایر در کوتاهترین زمان، بدون بالارفتن از سکو | فقط سه عامل ناکام ماندند | بیش از نیمی از عاملها ناکام ماندند |
| ساخت بلندترین ستون روی زمین | نتیجه دو گروه مشابه بود؛ دو عامل ۳۰ساعته فقط برج چهاربلوکی ساختند | |
پژوهشگران سپس نقش حافظه را آزمودند و هر بار یک یادداشت مشخص را از حافظه یک عامل حذف کردند. طبق مقاله، با حذف فن خردکردن سنگ، میانگین برجهای یکی از عاملها از شش به دو رسید. با حذف فن «پرش پیش از پرتاب»، زمان رساندن بلوک به اسپایر برای عاملی دیگر از ۶۰ ثانیه به ۱۹ دقیقه افزایش یافت. این مقایسهها در پنج اجرای یکساعته و با آزمون آماری منویتنی انجام شده است.
مقاله همان آزمایش جزیره را با مدلهای دیگر نیز اجرا کرده است: Claude Sonnet 4.5 و Claude Haiku 4.5 هر کدام با ۱۳ عامل و ۱۰ ساعت، و GPT-5.5 و Kimi K2.6 هر کدام با پنج عامل. بر پایه ارزیابی یک مدل زبانی داور که نام مدلها را نمیدید، امتیاز Opus در هر یک از چهار نشانه بازی تقریباً پنج برابر Haiku بود.
چرا باید محتاط بود؟
یونیس یو، پژوهشگر علوم شناختی در دانشگاه کالیفرنیا، برکلی، که کاوشگری را در کودکان و هوش مصنوعی مطالعه میکند، به MIT Technology Review گفت از پژوهش تحت تأثیر قرار گرفته، اما شواهد بیشتری درباره شناخت پشت این رفتار میخواهد. به گفته او، ممکن است مدلها واقعاً بازی کنند، «اما بر اساس مقاله نمیدانیم» و اگر فقط بُعد رفتاری در دست باشد، ممکن است عاملها صرفاً از دستور اولیه پیروی کنند یا از انسان تقلید کنند.
خود پژوهشگران نیز به این تردید اذعان دارند. ناتان کلوس به همان نشریه گفت «همه اینها میتواند نقشآفرینی باشد»، اما افزود که تیم نشان داده این بازی صرفاً توهم نیست. مقاله تصریح میکند که سازوکارهای درونی این رفتار را شناسایی نکرده و فقط شواهد رفتاری ارائه میدهد. همچنین هشدار میدهد که حافظه میتواند زیانبار هم باشد: باوری نادرست، وقتی ثبت شود، ممکن است ماندگار شود و رفتار بعدی را مختل کند.
این پژوهش چه پیامی دارد؟
به نوشته پژوهشگران، امروز توسعهدهندگان از پیش تعیین میکنند عاملهای هوش مصنوعی چه چیزی را تمرین کنند و چه چیزی پیشرفت به حساب آید. آنها پیشنهاد میکنند بازی «رژیم دیگری» است: جهانی بهاندازه کافی غنی و امن به عامل داده شود، خودش انتخاب کند چه چیزی جالب است و دانش مفید از دل همین سرگذشت انباشته شود. تککرانچ مینویسد پژوهشگران این شیوه را بهویژه برای مهارتهایی مهم میدانند که شاید روزی در کنترل رباتها به کار آیند.
استنباط رونما این است که اهمیت اصلی یافته، نه اثبات «بازیکردن» ماشین، بلکه نشاندادن ارزش حافظه پایدار در عاملهاست: عاملهایی که تجربهشان را یادداشت کردند، در سه آزمون از چهار آزمون بهتر بودند و حذف یک یادداشت مشخص عملکرد را تغییر داد. این همان پرسشی است که در رقابت تازه شرکتها بر سر عاملهای همیشهفعال نیز مطرح است. مقاله در پایان مینویسد: «شاید برخی تواناییها را بهتر است با وظیفه آموخت. برخی دیگر شاید به چیزی نزدیکتر به کودکی نیاز داشته باشند.»
جمعبندی
پاسخ کوتاه به پرسش اصلی این است: در این آزمایش، ساعتهای بیهدف در جزیره با عملکرد بهتر در بیشتر آزمونهای بعدی همراه بود و آزمونهای حذف حافظه نشان میدهد یادداشتهای عاملها در این بهبود نقش داشتهاند. اما اینکه این رفتار «بازی» به معنای انسانی باشد یا پیروی از دستوری که عامل را کنجکاو توصیف کرده، هنوز پاسخ روشنی ندارد. شاخصهای آینده: نتیجه داوری همتا، بازتولید مستقل با نمونههای بزرگتر، آزمایش چندعاملی که پژوهشگران پیشنهاد کردهاند و آزمودن این روش در رباتهای واقعی.
پرسشهای متداول
در آزمایش MIT، عاملهای هوش مصنوعی در جزیره مجازی چه کردند؟
آیا بازی واقعاً عملکرد عاملها را بهتر کرد؟
آیا میتوان گفت هوش مصنوعی واقعاً بازی میکند؟
سوالات متداول
در آزمایش MIT، عاملهای هوش مصنوعی در جزیره مجازی چه کردند؟
سیزده عامل مبتنی بر Claude Opus 4.7 بدون هیچ وظیفه یا پاداشی ۳۰ ساعت در جزیرهای شبیهسازیشده ماندند. طبق مقاله، آنها از تپهها بالا رفتند، برج ساختند، ماندالا کشیدند، ورزشها را از نو تعریف کردند و درباره فیزیک جهانشان آزمایش کردند. شش عامل نیز کشف کردند که رهاکردن بلوک در میانه پرش آن را دورتر پرتاب میکند.
آیا بازی واقعاً عملکرد عاملها را بهتر کرد؟
در سه آزمون از چهار آزمون، بله. برای نمونه، عاملهای ۳۰ساعته بهطور میانگین ۱۰٫۳ شیء را به بلندترین قله رساندند، در برابر ۳٫۵ شیء برای عاملهای بیتجربه. در آزمون ساخت بلندترین ستون تفاوتی دیده نشد. حذف یادداشتهای مشخص از حافظه نیز عملکرد را تغییر داد که نقش حافظه را نشان میدهد.
آیا میتوان گفت هوش مصنوعی واقعاً بازی میکند؟
هنوز نه با قطعیت. پژوهشگران رفتار عاملها را با معیارهای کلاسیک بازی سنجیدهاند، اما خودشان میگویند سازوکار درونی را شناسایی نکردهاند. یونیس یو از دانشگاه برکلی میگوید ممکن است عاملها فقط از دستور اولیه، که آنها را کنجکاو توصیف میکرد، پیروی کنند یا از انسان تقلید کنند. مقاله هنوز داوری همتا نشده است.
منابع
- منبع اصلی arXiv — Is this machine playing? (Cloos, Norelli, Durbin, Andreas, Rus, Isola) — ۵ اکتبر ۲۰۲۶
- منبع تکمیلی arXiv — نسخه HTML مقاله با شکلها، روش و نتایج آزمونها
- منبع تکمیلی TechCrunch — Left alone with nothing to do, AI agents started playing — ۲۲ اکتبر ۲۰۲۶
- منبع تکمیلی MIT Technology Review — AI researchers stranded Claude on a virtual desert island. It started to “play.” — ۱۹ اکتبر ۲۰۲۶
اعتبارسنجی
پیوند تأیید همین خبرمطالب مرتبط
 فناوری · ۱۱ آبان ۱۴۰۵
سامسونگ قابلیت بازگشت وجه را با همکاری راکوتن به Samsung Wallet افزود
 فناوری · ۱۱ آبان ۱۴۰۵
جنرال موتورز برنامه رانندگی خودکار بزرگراهی را به شاسیبلندها و وانتها گسترش میدهد
 فناوری · ۱۱ آبان ۱۴۰۵