
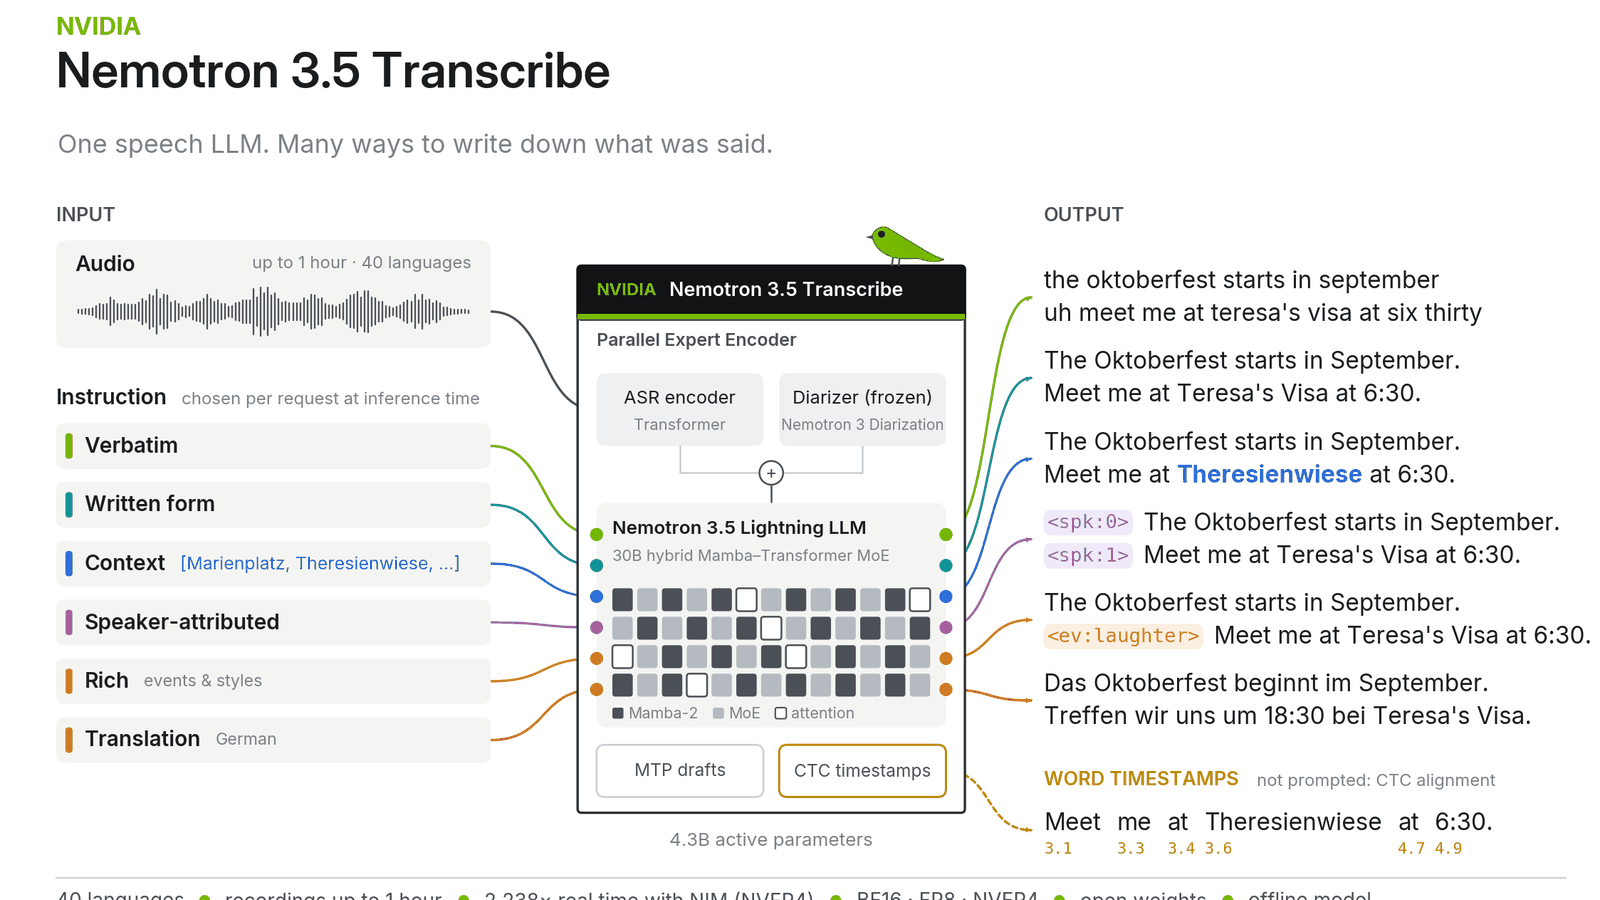
انویدیا مدل گفتار باز Nemotron 3.5 Transcribe را عرضه کرد؛ رونویسی، ترجمه و تشخیص گوینده در یک چکپوینت، اما فارسی در فهرست نیست
انویدیا مدل وزنباز Nemotron 3.5 Transcribe را برای رونویسی ۴۰ زبان، ترجمه و برچسبگذاری گوینده عرضه کرد؛ فارسی در فهرست زبانهای کارت مدل نیست.
تصویر: NVIDIA (تصویر hero کارت مدل Nemotron 3.5 Transcribe در Hugging Face)؛ برش ۱۶:۹ توسط رونما
در ۲۸ اکتبر ۲۰۲۶ (۶ آبان ۱۴۰۵) انویدیا مدل Nemotron 3.5 Transcribe را بهصورت وزنباز منتشر کرد؛ مدلی برای فایلهای صوتی ضبطشده که رونویسی ۴۰ زبان، ترجمه، برچسبگذاری گوینده و پرسشوپاسخ دربارهی صوت را در یک چکپوینت جمع میکند. انویدیا میگوید در تابلوهای مقایسهی متنباز جلوست. نکتهی قابلتوجه برای مخاطب فارسیزبان: فارسی در فهرست زبانهای پشتیبانیشده نیست.
در این خبر فناوری میخوانید
در یک نگاه
- ۴۰ زبان برای رونویسی، ۳۱ زبان برای ترجمه به/از انگلیسی و ۱۳ زبان برای تشخیص گوینده؛ ضبطهای تا یک ساعت و حداکثر هشت گوینده (وبلاگ Hugging Face، ۲۸ اکتبر ۲۰۲۶).
- میانگین خطای واژه (WER) ۵٫۳۳ درصد در ردیف انگلیسی تابلوی Open ASR هاب Hugging Face؛ رتبهی نخست میان مدلهای وزنباز به ادعای انویدیا.
- حدود ۴٫۳ میلیارد پارامتر فعال از حدود ۳۴ میلیارد پارامتر کل؛ مجوز OpenMDW-1.1 (کارت مدل).
- مجموعهدادهی Granary v2 با ۴۶۳٬۰۶۲ ساعت گفتار در ۴۸ زبان، در برابر ۲۵ زبان در نسخهی نخست (وبلاگ انویدیا در Hugging Face).
یک چکپوینت بهجای چند ابزار جدا
پرسش اصلی این است که عرضهی این مدل چه چیزی را در زنجیرهی گفتار به متن تغییر میدهد. تا امروز بیشتر تیمها برای رونویسی، تشخیص گوینده و ترجمه چند مدل جدا را به هم وصل میکردند. بر پایهی کارت مدل، Nemotron 3.5 Transcribe این کارها را با دستور متنی در یک مدل انجام میدهد: رونویسی، رونویسی با برچسب گوینده، ترجمه، زمانبندی واژهها، شناسایی زبان و پرسشوپاسخ صوتی.
ساختار مدل بر اساس کارت مدل یک رمزگذار گفتار موازی با رمزگذار گوینده است که به یک مدل زبانی ترکیبی Mamba–Transformer با معماری «ترکیب متخصصان» میپیوندد. کل پارامترها حدود ۳۴ میلیارد و پارامترهای فعال حدود ۴٫۳ میلیارد گزارش شده است. در متن وبلاگ انویدیا عدد «حدود ۳۰ میلیارد» هم آمده؛ رونما عدد کارت مدل را مبنا گرفته و این اختلاف را یادآوری میکند.
مدل برای صوت ضبطشده ساخته شده، نه پخش زنده. وبلاگ انویدیا صریحاً میگوید برای جریان زنده طراحی نشده است. نسخههای BF16، FP8 و NVFP4 منتشر شده و کارت مدل اجرای آن را روی یک کارت H100 با ۸۰ گیگابایت حافظه ذکر میکند. وزنها در Hugging Face و ModelScope در دسترساند.
کدام زبانها در فهرستاند؟
کارت مدل زبانها را در سه سطح کیفیت دستهبندی میکند: «پیشرو» (از جمله انگلیسی، فرانسوی، آلمانی، هندی، کرهای، روسی و اسپانیایی)، «آمادهی تولید» (از جمله ژاپنی، تایلندی، ترکی و اوکراینی) و «پشتیبانیشده، ممکن است نیازمند تنظیم دقیق» (از جمله عربی، عبری، چینی ماندارین و بنگالی). فارسی در جدول زبانهای کارت مدل دیده نمیشود. این به معنای «کار نمیکند» نیست؛ فقط یعنی پشتیبانی رسمی و ارزیابی منتشرشده وجود ندارد.
پیشینه و تاریخچه: از Granary تا Nemotron 3.5
این عرضه حلقهی تازهای از رشتهای است که انویدیا از ۲۰۲۵ پی گرفته: ساخت دادهی گفتار باز، سپس مدلهایی که روی آن آموزش میبینند. مقالهی Granary در مه ۲۰۲۵ منتشر شد و بر گردآوری گفتار برای ۲۵ زبان اروپایی تمرکز داشت. در اوت ۲۰۲۵ انویدیا مجموعهداده را همراه با مدلهای Canary-1b-v2 و Parakeet-tdt-0.6b-v3 در Hugging Face گذاشت.
- ۲۱ مه ۲۰۲۵مقالهی Granary برای ۲۵ زبان اروپایی در arXiv منتشر شد؛ جدول مقاله حدود ۶۴۳ هزار ساعت دادهی فیلترشدهی ASR را گزارش میکند.
- ۱۴ و ۱۵ اوت ۲۰۲۵Canary-1b-v2 در Hugging Face منتشر شد و وبلاگ انویدیا از Granary با حدود یک میلیون ساعت صوت (حدود ۶۵۰ هزار ساعت برای تشخیص گفتار و بیش از ۳۵۰ هزار ساعت برای ترجمهی گفتار) خبر داد.
- ۲۸ اکتبر ۲۰۲۶انتشار Nemotron 3.5 Transcribe و Granary v2 با ۴۸ زبان و ۴۶۳٬۰۶۲ ساعت در مانیفست عمومی.
دو نکتهی روششناختی مهم است. نخست، ۴۶۳٬۰۶۲ ساعت مربوط به انتشار مجموعهداده است، نه کل دادهی آموزش مدل؛ خود انویدیا این را تصریح میکند. دوم، گزارش فنی انویدیا مجموع دادهی آموزشی یکتای مدل را حدود ۱٫۷ میلیون ساعت برآورد میکند (برآورد از وضعیت نمونهگیر در چکپوینت). بنابراین Granary v2 بخشی از داستان است، نه همهی آن.
ادعاهای ارزیابی: چه چیزی گزارش شده است؟
همهی اعداد زیر ادعای انویدیا یا نقل از تابلوهای ثالثی است که انویدیا به آنها ارجاع میدهد و رونما آنها را مستقل بازتولید نکرده است. معیار «خطای واژه» هرچه کمتر باشد بهتر است.
| آزمون | نتیجهی گزارششده | منبع تابلو (به نقل انویدیا) |
|---|---|---|
| تشخیص گفتار انگلیسی | ۵٫۳۳٪ میانگین WER؛ نخست میان مدلهای وزنباز | Hugging Face Open ASR Leaderboard |
| چندزبانه (هفت زبان) | ۴٫۶۲٪ میانگین WER | مقایسهی کارت مدل |
| بلند (long-form) | ۱۰٫۹۸٪ میانگین WER | مقایسهی کارت مدل |
| شاخص AA-WER | ۲٫۸٪؛ برابر با بهترین وزنباز | Artificial Analysis |
| تشخیص گوینده در ۲۱ زبان | نرخ خطا ۱۸٫۲۶٪ (Nemotron 3 Diarization: ۱۸٫۳۸٪) | David AI DAI-ASR-I18N |
| جلسهی کامل انگلیسی با همپوشانی | cpWER برابر ۳۲٫۴٪؛ بهترین از ۱۴ سامانه | VoiceArena Diarization-Bench |
برای کاربرد تخصصی، وبلاگ انویدیا یک مطالعهی موردی پزشکی روی مجموعهی Eka Care گزارش میکند: تنظیم دقیق خطای واژهی دادهی کنار گذاشتهشده را از ۲۲٫۴۴٪ به ۱۲٫۱۷٪ رساند، یعنی ۴۵٫۸٪ کاهش نسبی؛ در همان مطالعه، خطا روی LibriSpeech test-clean از ۱٫۵۴٪ به ۱٫۶۹٪ رفت. این هم برای فهم تعادل میان تخصص و عمومیت مفید است.
بازار و سهام
پیامد بازاری مستقیم گزارش نشده است. این مدل رایگان و وزنباز است و در منابع خواندهشده تغییر قیمت سهام انویدیا (NVDA) یا شرکتهای دیگر به آن نسبت داده نشده؛ بنابراین واکنش بازار تأییدنشده است و رونما عددی ارائه نمیکند. برای پیگیری بازار جهانی، سهام فناوری، رمزارز و کالا به نقشه بازار رونما و برای سهام انویدیا به صفحهی سهام بازار رونما سر بزنید.
از زاویهی راهبردی، عرضهی مدلها و دادههای باز بخشی از الگوی گستردهتر انویدیا است: مدل باز ۱۲۰ میلیارد پارامتری که رونما پیشتر پوشش داد نشان میدهد سازندهی تراشه حالا در لایهی مدل هم حضور دارد. این برداشت استنباط رونما است، نه ادعای شرکت.
تأثیر و راهکارها
تأثیر فنی و اقتصادی
برای تیمهای محصول، مهمترین اثر کاهش پیچیدگی است: یک مدل با دستور متنی میتواند فرمت خروجی، اصطلاحات تخصصی و برچسب گوینده را کنترل کند. انویدیا برای اجرا از vLLM و SGLang-Omni از روز نخست و نقاط پایانی میزبانیشدهی Baseten و DeepInfra نام میبرد. در حوزهی دفاع سایبری و مدلهای باز، گزارش رونما دربارهی گشودن وزنهای میسترال نمونهی دیگری از همین روند است.
برای کاربران ایرانی، کانال اثر مستند و مشخصی در منابع خواندهشده گزارش نشده است. اثر عملی دو قید دارد: فارسی در فهرست رسمی نیست، و تحریمها و محدودیت دسترسی به برخی خدمات ابری ممکن است دریافت یا میزبانی را دشوار کنند؛ این مورد برای هر تیم باید جداگانه بررسی شود. عربی، ترکی، عبری و هندی در فهرستاند و برای پروژههای منطقهای میتوانند نقطهی شروع باشند.
راهکارها و توصیههای عملی
الف) توسعهدهندگان، مهندسان و مدیران فنی. پیش از مهاجرت از سامانهی فعلی، مدل را روی نمونهی واقعی و برچسبخوردهی خودتان بسنجید؛ خود انویدیا توصیه میکند دستکم ۱۰۰ نمونهی واقعی برای انتخاب چکپوینت داشته باشید. نامها، تغییر گوینده و پاسخهای پرسشوپاسخ صوتی را با ضبط اصلی مقایسه کنید. سرویس زندهی بلادرنگ را با این مدل طراحی نکنید. مجوز OpenMDW-1.1 و مجوز هر پیکرهی صوتی را جداگانه بخوانید؛ انویدیا میگوید صوت منبع باید طبق مجوز اصلی هر پیکره دانلود شود.
ب) سرمایهگذاران و فعالان بازار. این بخش توصیهی خرید یا فروش نیست. موارد قابل رصد: پذیرش مدل در سرویسهای ابری و نقاط پایانی میزبانیشده، اضافهشدن زبانهای تازه، بازتولید مستقل نتایج روی تابلوها و تعامل رقابتی با مدلهای بستهی گفتار. ریسکها شامل تکیه بر ادعای تولیدکننده، رقابت مدلهای باز دیگر و وابستگی عملکرد به سختافزار انویدیا است.
ج) کاربران نهایی و کسبوکارها. اگر صورتجلسه یا مصاحبه ضبط میکنید، بدانید ابزارهای ساختهشده روی این مدل در آینده برچسب گوینده هم میدهند؛ اما خروجی ماشینی را برای مستندات حقوقی یا پزشکی بدون بازبینی انسانی نپذیرید. حریم خصوصی صدا را جدی بگیرید: اجرای محلی یا روی سرور خودتان یکی از مزیتهایی است که انویدیا برجسته میکند.
ضدتحلیل و محدودیتها
قویترین اعتراض این است که تابلوها همیشه واقعیت تولید را نشان نمیدهند. نتایج روی مجموعههای شناختهشده اندازهگیری شدهاند، بخشی از نتایج بهادعای خود انویدیا و تابلوهایی است که به آن ارجاع میدهد، و رونما هیچکدام را مستقل اجرا نکرده است. پشتیبانی چندگویندگی فقط برای ۱۳ زبان است، پرسشوپاسخ صوتی فقط در انگلیسی ارزیابی شده و کارت مدل هشدار میدهد بیرون از انگلیسی ممکن است قابلاعتماد نباشد.
Nemotron 3.5 Transcribe چه کارهایی انجام میدهد؟
بر پایهی کارت مدل انویدیا، این مدل صوت ضبطشده را رونویسی میکند، به/از انگلیسی ترجمه میکند، گویندهها را برچسب میزند، زمان واژهها را میدهد و به پرسشهای دربارهی صوت پاسخ میدهد. برای ۴۰ زبان رونویسی و برای ۳۱ زبان ترجمه ارائه میشود.
آیا فارسی پشتیبانی میشود؟
در جدول زبانهای کارت مدل، فارسی دیده نمیشود. عربی، ترکی، عبری و هندی در فهرست هستند. نبودن فارسی در فهرست یعنی پشتیبانی رسمی و نتیجهی ارزیابی منتشرشدهای وجود ندارد، نه اینکه آزمون شده و شکست خورده باشد.
آیا مدل برای رونویسی زنده مناسب است؟
خیر. انویدیا میگوید مدل برای صوت ضبطشده ساخته شده، نه جریان زنده. ضبطها تا یک ساعت و حداکثر هشت گوینده پشتیبانی میشوند.
Granary v2 چیست؟
مجموعهداده و خط تولید باز انویدیا برای آمادهسازی دادهی گفتار است. مانیفست عمومی آن ۴۶۳٬۰۶۲ ساعت در ۴۸ زبان را پوشش میدهد، در برابر ۲۵ زبان در نسخهی نخست. صوت منبع باید طبق مجوز هر پیکره جداگانه دانلود شود.
نتایج رتبهبندی مستقل تأیید شده است؟
اعداد از وبلاگ و کارت مدل انویدیا و تابلوهایی است که به آنها ارجاع میدهد. رونما آنها را مستقل بازتولید نکرده؛ بنابراین باید روی دادهی خودتان آزمایش کنید.
سوالات متداول
Nemotron 3.5 Transcribe چه کارهایی انجام میدهد؟
بر پایهی کارت مدل انویدیا، این مدل صوت ضبطشده را رونویسی میکند، به/از انگلیسی ترجمه میکند، گویندهها را برچسب میزند، زمان واژهها را میدهد و به پرسشهای دربارهی صوت پاسخ میدهد. برای ۴۰ زبان رونویسی و برای ۳۱ زبان ترجمه ارائه میشود.
آیا فارسی پشتیبانی میشود؟
در جدول زبانهای کارت مدل، فارسی دیده نمیشود. عربی، ترکی، عبری و هندی در فهرست هستند. نبودن فارسی در فهرست یعنی پشتیبانی رسمی و نتیجهی ارزیابی منتشرشدهای وجود ندارد، نه اینکه آزمون شده و شکست خورده باشد.
آیا مدل برای رونویسی زنده مناسب است؟
خیر. انویدیا میگوید مدل برای صوت ضبطشده ساخته شده، نه جریان زنده. ضبطها تا یک ساعت و حداکثر هشت گوینده پشتیبانی میشوند.
Granary v2 چیست؟
مجموعهداده و خط تولید باز انویدیا برای آمادهسازی دادهی گفتار است. مانیفست عمومی آن ۴۶۳٬۰۶۲ ساعت در ۴۸ زبان را پوشش میدهد، در برابر ۲۵ زبان در نسخهی نخست. صوت منبع باید طبق مجوز هر پیکره جداگانه دانلود شود.
نتایج رتبهبندی مستقل تأیید شده است؟
اعداد از وبلاگ و کارت مدل انویدیا و تابلوهایی است که به آنها ارجاع میدهد. رونما آنها را مستقل بازتولید نکرده؛ بنابراین باید روی دادهی خودتان آزمایش کنید.
منابع
- منبع اصلی NVIDIA در Hugging Face — Nemotron 3.5 Transcribe and Granary v2 — ۲۸ اکتبر ۲۰۲۶
- منبع تکمیلی کارت مدل NVIDIA-Nemotron-3.5-Transcribe-30B-A4B در Hugging Face
- منبع تکمیلی NVIDIA — Nemotron 3.5 Transcribe Technical Report — ۲۸ اکتبر ۲۰۲۶
- منبع تکمیلی The Next Web — Nvidia releases an open speech model that transcribes 40 languages — ۲۸ اکتبر ۲۰۲۶
- منبع تکمیلی NVIDIA Blog — Now We’re Talking: Open Dataset, Models for Multilingual Speech AI — ۱۵ اوت ۲۰۲۵
- منبع تکمیلی arXiv — Granary: Speech Recognition and Translation Dataset in 25 European Languages — مه ۲۰۲۵
- منبع تکمیلی کارت مدل nvidia/canary-1b-v2 در Hugging Face
اعتبارسنجی
پیوند تأیید همین خبرمطالب مرتبط
 فناوری · ۱۱ آبان ۱۴۰۵
سامسونگ قابلیت بازگشت وجه را با همکاری راکوتن به Samsung Wallet افزود
 فناوری · ۱۱ آبان ۱۴۰۵
جنرال موتورز برنامه رانندگی خودکار بزرگراهی را به شاسیبلندها و وانتها گسترش میدهد
 فناوری · ۱۱ آبان ۱۴۰۵